الخلاصة
- ديب إل أعلنت إطلاق نموذج Aure الصوتي الذي ينقل تغيّرات النبرة والإيقاع أثناء الترجمة الفورية
- النموذج يعمل داخل منتج DeepL Voice ويدعم 8 لغات في مرحلته الأولى، بصوت المتحدث نفسه
- الشركة تراهن على أن حفظ طريقة الكلام يرفع قيمة الترجمة في التفاوض وبناء الفرق الدولية
خبر:
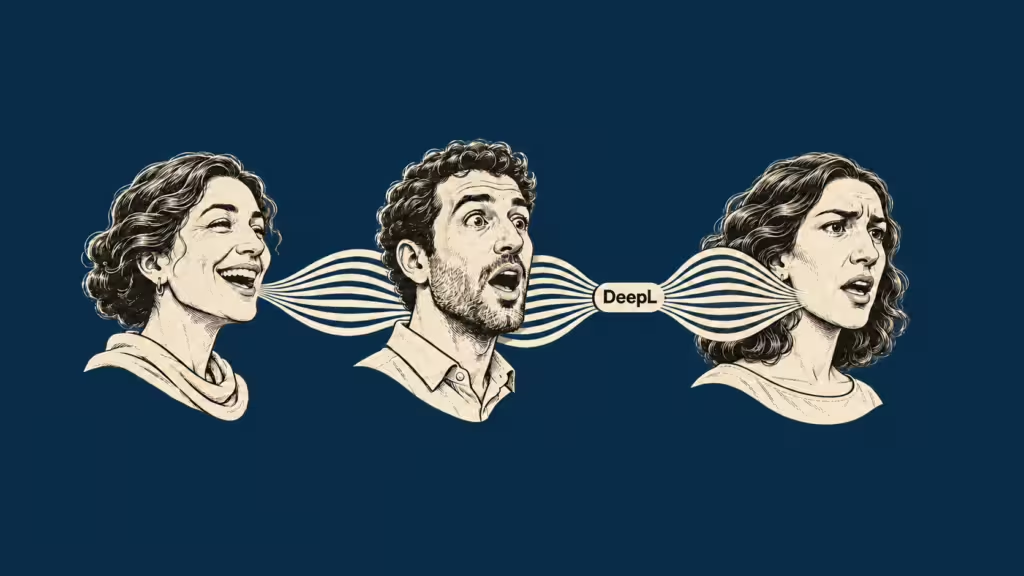
نموذج صوتي جديد يحمل اسم Aure بات يحلّل الكلام الوارد بشكل متواصل ليعيد إنتاجه في لغة أخرى مع تغيّرات النبرة والانفعال والتشديد والسرعة، بحسب بيان أصدرته شركة ديب إل من كولونيا في 11 نوفمبر 2026. وقالت الشركة إن النموذج يشغّل منتجها للترجمة الصوتية الفورية DeepL Voice. ويعمل تلقائياً دون أي إعداد إضافي من المستخدم.
تفصيل:
- ما الجديد: بحسب ديب إل، كان النموذج السابق يبني الصوت المترجَم على عيّنة ثابتة تُلتقط من اللحظات الأولى للمحادثة، ما يحدد هوية المتحدث لكنه لا يلاحق تغيّر الانفعال أو الإيقاع. Aure يعتمد بدلاً من ذلك على تحليل مستمر يجمع بين الكلمات المترجَمة والصوت الأصلي لتحديد طريقة أداء الجملة.
- اللغات المدعومة: الشركة قالت إن النموذج يدعم في مرحلته الأولى 8 لغات هي الإنجليزية والألمانية والإسبانية والفرنسية والإيطالية واليابانية والبرتغالية والكورية، مع لغات إضافية لاحقاً. ولم تحدد ديب إل موعداً لتوسيع القائمة، وستظل بقية اللغات مدعومة عبر النماذج الصوتية القائمة.
- نطاق التشغيل: وفق البيان، تُطبَّق قدرات Aure تلقائياً عبر ثلاث واجهات: DeepL Voice للاجتماعات عبر الإنترنت، والنسخة الخاصة بالمحادثات المباشرة وجهاً لوجه، وواجهة برمجة التطبيقات الصوتية DeepL API for Voice، دون الحاجة إلى ضبط إعدادات من جانب العميل.
- موقف الرئيس التنفيذي: ياريك كوتيلوفسكي، الرئيس التنفيذي ومؤسس ديب إل، قال إن الصوت ليس ثابتاً وإن البشر يعدّلون نبرتهم وسرعتهم باستمرار بما يغيّر معنى كلامهم. وأضاف أن التواصل بين اللغات ظل لوقت طويل يفرض تنازلاً عن طريقة التعبير، وأن الشركة تسعى لعكس هذه المعادلة.
- التحديات التقنية: ديب إل ذكرت أن النموذج يحتاج إلى عزل هوية الصوت وملامح الأداء عن الضجيج والصدى والتشويش في المحادثات الواقعية، وأن نقل الصوت بين لغات مختلفة أعقد بكثير من نقله داخل اللغة الواحدة، خصوصاً دون تضخيم اللكنة أو تشويه طريقة نطق المتحدث.
- قيود البيانات: وفق الشركة، لا يحتفظ DeepL Voice بمحاضر الاجتماعات أو الترجمات بشكل دائم، ويمحو هذه البيانات من الذاكرة عند انتهاء الجلسة، ما يترك النموذج ببيانات واقعية محدودة للمتحدث نفسه عبر لغات متعددة. لذلك يتعيّن عليه التكيّف مع كل متحدث آنياً قبل إتمامه الجملة.
- أسلوب التدريب: الشركة قالت إنها دمجت تقنيات تدريب تفصل هوية الصوت عن ملامح الأداء عن المحتوى المنطوق، بحيث يُنقل كل عنصر إلى اللغة الجديدة بشكل مستقل. وأضافت أن التعلّم المعزّز يحسّن المخرجات للحفاظ على دقة الترجمة وجودة الكلام وإنتاج نطق طبيعي خالٍ من اللكنة.
- البناء على السابق: بحسب البيان، يأتي Aure بعد إطلاق تقنية حفظ الصوت التي سمحت للمستخدمين بالتحدث عبر اللغات بأصواتهم المميّزة بدل صوت اصطناعي عام. وتصف الشركة النموذج الجديد بأنه الخطوة التالية: رصد كيفية تغيّر ذلك الصوت وتفاعله على امتداد المحادثة.
- الاعتماد التجاري: ديب إل أوردت أن بين مستخدمي DeepL Voice شركات منها بايونير وأرامارك وأفيندرا إنترناشونال وإنيتوم. وقالت إن المنتج أُدرج في قائمة فاست كومباني لعام 2026 لأبرز الابتكارات التقنية ضمن فئة الذكاء الاصطناعي التطبيقي.
- حجم الشركة: وفق التعريف المرفق بالبيان، تأسست ديب إل عام 2017 ويزيد عدد موظفيها على 900، ويستخدم منصتها أكثر من 200 ألف فريق عمل إضافة إلى ملايين الأفراد، بدعم من مستثمرين بينهم بنشمارك وآي في بي وإندكس فينتشرز.
بين السطور:
الرهان التجاري واضح في طريقة تسويق النموذج: ديب إل لا تعرض Aure كتحسين في دقة الترجمة بل كأداة لنقل الثقة والشخصية في التفاوض وبناء العلاقات مع العملاء. وتقدّم الشركة قيود الاحتفاظ بالبيانات، التي تصفها كعائق تقني أمام التدريب، باعتبارها في الوقت نفسه ميزة أمنية موجّهة للعملاء المؤسسيين.
ماذا بعد؟
المؤشر الأقرب هو إعلان ديب إل عن اللغات الإضافية التي وعدت بدعمها، ومدى انتقال العملاء المؤسسيين المعلنين من النماذج الصوتية القائمة إلى Aure داخل واجهات الاجتماعات والمحادثات المباشرة.